
一. 前言
本篇文章介绍了大语言模型时代下的 AI Agent 概念,并以 LangChain 为例详细介绍了 AI Agent 背后的实现原理,随后展开介绍云音乐在实践 AI Agent 过程中的遇到的问题及优化手段。通过阅读本篇文章,读者将掌握业界主流的 AI Agent 实现原理及实践优化手段,对应用自研 AI Agent 或理解 Open AI 最新提出的 Assistants API 都具有一定的参考价值。
二. AI Agent 简介
2.1 什么是 AI Agent ?
相信阅读这篇文章的读者,都在今年感受到了大语言模型带来的爆炸影响力,也都有过与之直接进行交互的使用经历,感受到了它的强大和无所不知。
但大语言模型也存在一些限制,比如:
- 他的数学计算能力相对薄弱,对于复杂的运算可能会出现错误。(如问 3457 * 43216 = ?,它可能会回答 149,623,912。这是错的正确答案是 149,397,712)
- 训练的数据集不包含近期的数据,所以无法直接知道最近的天气和最近发生的新闻。(OpenAI 近期推出的 gpt-4-1106-preview 的训练数据集更新至 23 年 4 月)

区别于直接与大语言模型进行对话,AI Agent 是通过工程化的手段,为大语言模型提供了获取外部工具、知识的能力。他是介于人类、大语言模型之间的代理。 当用户向 AI Agent 输入问题时,AI Agent 可以使用大语言模型作为推理引擎,将一个复杂的任务进行分解、给出任务执行规划。 之后 Agent 会调用外部工具获取结果,并将大语言的上次推理和工具调用结果返回给大语言模型,让大语言模型继续思考、规划。如此循环,直到将一个复杂的任务完成。

基于以上的理解,我们可以给 AI Agent 下一个定义:
他是人与大模型之间的智能代理,在接到任务时,它会使用大语言模型作为推理引擎,进行自主的任务规划、执行调度。
2.2 AI Agent 的应用场景
AI Agent 又有哪些应用场景呢?在《AI Agent 的千亿美金问题》这篇文章中,作者详细介绍了 AI Agent 的应用场景,笔者从中引用 3 个大家可能比较熟悉的例子:
1. AI 辅助编程场景
Cursor
Cursor 将自己的产品称为 AI-first IDE,其产品 UI 与 VS Code 接近,加入了很多 LLM 原生的 feature,比 Github Copilot 能做得更深入。可以认为是 AI agent 化的 VS Code + Github Copilot.
Vercel v0
v0 是由 Vercel 团队打造的 AI 前端代码生成工具。其使用过程非常直接:用户使用自然语言描述需求,v0 根据需求描述来生成组件代码。然后用户继续对不满意的地方提出修改意见,将其迭代为 v1、v2... 直到满足用户的要求。当用户想将一个生成网页的标题改为渐变色时,只需要选择标题部分并提出“增加一个渐变色”,产品便会只对这一部分代码进行修改。

2. 个人助理类场景
Lindy.AI
Lindy.ai 是一款基于办公场景的智能个人 AI 助手产品,帮助用户智能化处理日常办公任务。它可以帮人类做日程规划预定、邮件起草发送、会议纪要撰写和总结等。

三. 如何来构建 AI Agent ?
对 AI Agent 做了简要的介绍后,我们接着来看,如何构建 AI Agent?目前市面上比较火的 Agent 相关的项目有 AutoGPT、BabyAGI、LangChain 等。
- AutoGPT 在今年 3 月份发布后取得了惊人的增长,目前已经是一个 152k start 的项目。
- BabyAGI 则提出了 Plan and execute Agent,他的实现方式是: 一次性对任务做全局的规划,后续严格一步步执行,不再变更任务计划。
- LangChain 则是一个通用的大语言模型应用层开发框架,提供了 Python、TS 两种语言库,内置各种 LLM 工具,在 Agent 领域,它也提供了多种 Agent 的实现思路,包括了 AutoGPT、BabyAGI 的实现,本文选择 LangChain 展开介绍。

3.1 LangChain Agent 使用示例
前文提到 LLM 不擅长解决复杂数学计算,我们接着来看 LangChain 使用外部工具来增强 LLM 的数学运算能力的官方示例。本示例的用户提问是: "5~10 之间的随机数的平方是多少?" 。
一共分为 4 大步:

- 初始化大语言模型接口,可以传入 modelName、temperature、maxTokens 等参数。
- 初始化工具列表,示例中使用了一个 LangChain 内置的计算器工具,以及动态构建工具。我们重点来看下这个动态生成工具:
- name 是工具的名字
- description 是工具的介绍,是供大语言模型理解的。
- schema 是工具的入参定义 ,这里定义了 low 和 hight 都是数字类型,分别代表 随机数的 下界 和 上界。
- func 是工具的方法调用定义,参数是 schema 中的定义,函数体是一段 js 随机数生成代码。
- 有了工具和大语言模型接口后,随后构造出了 Agent 执行器。
- 最后一步是将用户的输入传给 Agent 执行器。
最后输出的随机数平方是 45.067
3.2 LangChain Agent 执行步骤拆解
在本地执行的过程中,Langchain 会输出详细的执行调度日志,如下图所示:


通过分析这些日志可以揭开 Langchain Agent 背后的运行原理。
执行步骤一: 调用大语言模型
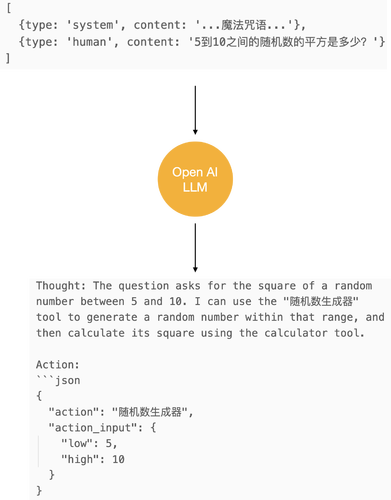
如下图所示, Agent 执行的第一步是将用户的输入与一个系统的 prompt 进行组装,我们暂时先称其为 “魔法咒语”,后续会详细介绍。大语言模型会返回他的思考: "用户的问题是 5~10 之间的随机数的平方。我可以使用「随机数生成工具」先生成一个随机数,然后使用计算器工具计算它的平方。" 并以 JSON 指示下一步采取的动作是: 调用「随机数生成工具」,入参为 low 5, high 10。
执行步骤二: 调用工具-随机数生成器
接着 Agent 执行器 会调用「随机数生成工具」入参为 {low:5, hight:10},工具返回 6.7132

执行步骤三: 调用大语言模型
如下图所示,Agent 执行器会把用户的原始问题,和上一步大语言模型的思考、工具调用和工具的输出做拼接,传给大语言模型继续思考。大语言模型回复说: 随机数是 6.71..,现在我可以使用计算器工具来计算它的平方值。并使用 JSON 格式指示下一步动作是: 调用计算器工具,入参是 6.71..的平方的数学描述。

执行步骤四: 调用工具 计算器
接着 Agent 执行器 会调用 计算器工具,入参为 6.71...^2,计算器工具返回的结果为 45.06..

执行步骤五: 调用大语言模型
如下图所示: Agent 执行器将上一步的思考、工具调用、结果做拼接,传递给大语言模型继续思考。大语言模型回复说: 我知道了最终的结果,答案是 45.067

当我第一次运行 Agent 示例,看到 Agent 能如此丝滑地一步步思考,执行外部工具,并得到最终结果时,我非常惊叹于 Agent 的能力,也十分好奇背后的原理的是什么。经过一番探索,发现其核心原理就藏在魔法咒语里。 我们接着来看这里的魔法咒语是什么?
3.3 LangChain Agent 的魔法咒语
魔法咒语片段一
魔法咒语是由多个片段组成,片段一指示了大语言模型可以使用一些工具,但必须要遵循工具的 JSON Schema,然后给出了 合法的 JSON Schema 示例。紧接着给出了大语言模型可用的工具介绍,包含工具的名字、工具的描述和入参的 JSON Schema。

魔法咒语片段二
片段二主要指示大语言模型如何使用工具。需要通过一个 JSON markdown 格式包裹,包含 action 和 action_input 字段,action 必须为 Final Answer 或 工具名。并给出了 Action 的示例。

魔法咒语片段三
我们知道大语言模型是生成式 AI,而片段三指示了大语言模型生成的内容需要遵循的段落结构。分别是:
- Question 问题是什么
- Thought 思考如何去解决
- Action 下一步采取的行动
- Observation: 行动的结果
并指示生成的思考、行动、结果 是可以重复 N 次的。并指示 LLM 在知道最终的结果后,输出 Final Answer。
这一段是大语言模型能将复杂任务分解、逐步执行、继续思考如此循环的关键。而这一思考框架称为 ReAct。

知道了 LangChain 背后的魔法咒语后,我们能否直接在 ChatGPT 中直接输入魔法咒语试下效果呢?答案是可以的。
我们把这段魔法咒语直接复制到 ChatGPT 上。我们看到大模型确实按照 Thought、Action、Observation 的段落格式进行生成输出。

但好像又有点问题,他返回的结果和此前步骤拆解中的步骤一不太一样。步骤一只返回 需要调用「随机数生成器工具」,随后 Agent 会介入工具调用,完成工具调用后再交由大语言模型进行思考,而这里大语言模型直接返回了后续的工具调用结果、下一步思考、下一步的行动,在多步重复后,把一个错误的结果输出给我们了,那么问题出在了哪里呢?
事实上在 Agent 执行器调用大语言模型时,有一个关键的参数 Stop Sequences,这个参数的作用是让大语言模型在准备生成这个词前就强制停住,不再往下生成。
Agent 会传入 Observation 作为这个参数的值,意思就是让大语言模型生成到 Observation 时就强制停止,这样控制权才会转交回给 Agent,Agent 可以继续调用外部工具、执行后续的步骤。
我们在 ChatGPT 上加上这个参数,这一次大语言模型的输出就符合预期了。以上就是 LangChain Agent 的核心原理。

四. 云音乐 Adora 平台在 Agent 方面的实践
Adora 是网易云音乐内部的智能数字助理搭建平台,提供 LLM 相关服务。内置专属 Chat UI 界面、配置中心,可轻松实现知识库管理、智能问答、意图识别、行为翻译等功能。帮助用户快速构建属于自己的智能助手。我们后续也会有文章介绍 Adora,各位读者敬请期待。

4.1 基础能力整合
接着我们来看云音乐 Adora 平台在 Agent 方面的实践。首先是基础能力整合。
步骤一
我们还是基于这段官方示例进行扩展。这里的 ChatOpenAI 是 LangChain 提供的大语言模型接口,底层是调用的 OpenAI 官方 Client。由于各种原因,我们无法直接使用,所以要做下替换。

得益于 LangChain 的面向对象封装,我们只需继承 LangChain 的 ChatOpenAI 类,重写其中的一个函数即可。将 OpenAI 官方 Client 调用 替换为内部封装的 gpt-client 即可。

步骤二
第二步是将 Adora 平台在线录入的服务转换为 LangChain 的 Tools。我们在 Adora 原有的服务定义上,增加了 description_for_ai 字段,以及 input_params 字段,有了这些配置,我们就可以将 Adora 在线录入的服务,转换为 LangChain 的 Tool。

做完了以上的两步,再加上一些胶水代码,我们就为 Adora 平台整合入了 Agent 的能力。
Adora 平台的用户在创建 Agent 智能体时,只需在可视化界面上,选择 Agent 智能体动作,并圈选这个 Agent 所需的服务,即可完成一个 Agent 的构建。

在完成基础能力的整合后,我们还遇到了哪些问题,以及做了哪些优化呢?
4.2 问题及优化手段
问题 1: 如何高效地调试 Agent ?
我们此前提到 Agent 在执行时会输出日志,对于我们理解 Agent 的执行逻辑很有帮助,但这些日志也存在一些冗余的信息,并且是平铺式的,难以快速提炼关键信息。

我们做的第一步是将这些输出日志做采集、提炼。将 Agent 的执行步骤,归纳为关键的 Thought 和 Tool 两大步骤,并以结构化的方式在前端做呈现。
如下图所示,在 Thought 中我们会展示此次调用大语言模型的 system prompt、human input,以及大语言模型的回答,并展示出整体的耗时。

在 Tool 环节,会展示 Agent 使用的工具、耗时。以及工具的入参和出参。


通过结构化的展示,我们将 Agent 执行的每一步,都可视化呈现在开发者眼前,若 Agent 的思考出错或工具调用传参不对,开发者都可以及时看到,并通过改进 prompt 优化整体效果。
值得一提的是 LangChain 官方出品的开发者平台 LangSmith,也将 Agent 的执行可视化作为了关键特性在宣传,可见可视化调试的重要性。

问题 2: 如何解决 Agent 执行的异常中断
我们在调试过程中发现,当 LLM 返回的 action_input 不符合工具的 schema 定义时,Agent 会执行抛错,中断整体执行逻辑。 此外在外部接口调用返回异常时,tool 也会直接抛错,导致 Agent 的整体执行逻辑中断。
举例来说,正常情况下使用 「会议室查询」服务,需要有 buildingName、bookDay 两个参数,我们也在 Prompt 中提示了大语言模型这两个字段为必填项。
但 LLM 由于上下文信息过多,可能会出现遗忘的现象。导致输出的结果中,遗漏了 buildingName 字段。当前 LangChain 的默认处理是当 Schema 校验不通过时,直接抛错,这样 Agent 的执行就结束了。

我们的优化做法是改写 DynamicStructuredTool 逻辑,在入参不符合预期时,不直接抛错,而是给 LLM 返回错误提示,让其继续思考。这样 LLM 在看到上一次工具的输入、错误提示后,在下次思考时,就会尝试纠正自己,给出正确的工具入参。具体的改写代码如下所示:

同理在接口调用环节,如果遇到外部返回异常时,也可以采样同样的思路进行优化。比如会议预定接口,假设接口调用时传入了一个已被占用的时段,后端接口响应就会返回 { code: 400 ,message: 该时段已被占用} , 此时在 request 中,遇到返回码非 200 时,不直接抛错,而是包装一个错误信息返回给 LLM,这样 LLM 在下次思考时,也会纠正自己,尝试给出合理的工具入参。参考代码如下所示:

问题 3 如何让 Agent 请求用户协助?
我们此前提到,Agnet 的执行过程,只有思考、工具调用的重复循环,直到给出任务执行的最终结果。中间没有留给用户介入的机会。

但我们在一些场景,我们是希望能有用户介入的机会,比如在订咖啡、订会议室的场景,在上下文信息不足时,我们希望 Agent 能够向用户去征集偏好、选项,而不是自行决策,一条路走到黑,导致预定失败。
我们的做法是: 首先调整工具的描述,告知 LLM 在不知道参数时,需要向用户提问。

但只靠这一步,效果并不好,有时 LLM 的输出会不符合 Action 格式要求,所以我们还对系统提示词做了逐步的调整,以强化对 LLM 的提醒。

通过以上的 Prompt 优化,现在当输入 「今天下午有哪些会议室?」时,大语言模型会回复「请问您想要查询 1 号楼、2 号楼还是 3 号楼的会议室?」。现在大语言能够正确地向用户提问了,把控制权交给了用户,后续用户回答 「2 号楼」时,我们只需将上一轮的对话作为记忆带到下一轮的 Agent 执行中,就达成了人工介入 Agent 补充信息的效果。以会议室预定为例,详细的步骤如下所示:

最终实现的效果:

我们通过可视化调试界面加深下理解: 在第三轮对话的第一个 Thought 环节。第一条 system 为系统提示词,后续的 human、ai、human、ai 是前两轮的对话记忆,最后一个 human 才是第三轮对话的用户输入,这 6 消息整体作为入参 messages 发送给 LLM ,最后一条 ai 是这次调用 LLM 的返回结果。

会议预定 Agent 完整执行步骤如下:


问题 4 模型推理能力、响应速度
在实践中,我们遇到的最大问题是模型的推理能力与响应速度无法兼得。举例来说,当我以 「帮我预定 2 号楼 7 楼 今天下午 3 点到 5 点的会议室」 这个问题进行测试时,gpt-4.0-0613 模型分别以 19.07 秒、24.78 秒、19.01 秒完成任务,中间没有任何步骤推理出错。而使用 gpt-3.5-turbo-0613 模型时,在第一次测试时,Agent 调用的 tool 并不存在,导致任务失败,第二次测试时,Agent 第一步调用 tool 仍然不存在,但在第二步思考时,Agent 进行了纠正,整体完成任务耗时为 13.51 秒。第三次测试时,Agent 一次性完成了任务,仅耗时 8.09 秒。
下图为 gpt-3.5-turbo-0613 第二轮测试效果:

整体测试总结来看,gpt4.0-0613 可以以 100%的正确率完成任务,但平均解题耗时需要 20+秒,而 gpt-3.5-turbo-0613 虽然任务完成率只有 66% ,但整体耗时仅为 10.8 秒。

对于 gpt-4 的推理能力更强,应该是符合我们大家直觉的,但耗时更久却有点反直觉。我们随后查看了官方的文档,在文档中可以看到,gpt-4 的 出字速度确实是比 gpt-3.5 要慢上几倍,这是符合官方预期的。

受限于推理能力、响应速度难以兼得。当下想要将 Agent 正式投入生产环境,还是有一些挑战的。比如当我们把会议预定、咖啡预定 Agent 在公司 1024 的活动上推出时,部分用户身上表现出了一定的等待焦虑:「为什么还没有反应」「我还要等多久」「是不是挂了」。
在这里工程上能做的优化可能比较有限,比如除了 Loading 外,我们可以加入一些其他的响应提示,如 Agent 目前的思考步骤,以缓解用户的焦虑。
整体上,推理能力与速度的同步提升,还是较大依赖大模型厂商的逐步优化。正如 OpenAI 最新发布的 gpt-4-turbo-1106 在响应速度上就已经有了一些提升。我们相信随着推理能力和响应速度的提升,基于大语言模型实现的 AI Agent 在不远的未来会有大规模的落地的可能。

五. 总结
在 11 月的 OpenAI 的开发者大会上,官方同时也发布了最新的 Assistants API ,为构建 AI Agent 提供了官方支持,使得 AI Agent 的构建更加简单、高效。虽然官方的方案可能会演变为最终方案,但我们相信对 LangChain Agent 的实践不会白费,他会加深我们对 Agent 发展脉络的理解,而且使用过后,我们就会发现 Assistants API 的封装 与 LangChain Agent 有许多共通之处。我们后续也会对此进行跟进、实践,请大家继续关注我们,我们会第一时间分享我们的实践经验。
引用